
🌍 Italiano · Read in English →
Tutto nasce da un'idea un po' testarda: far girare un piccolo modello linguistico — uno che genera testo, come i suoi fratelli giganti — su un hardware minuscolo. Poca memoria. Niente GPU, niente cloud, niente rack.
Quando la memoria si conta in megabyte (esatto, megabyte), non puoi permetterti di usare le cose senza capirle. Ogni scelta architetturale diventa una domanda concreta: quanto mi costa, in byte? E rispondendo a queste domande, i concetti che sembrano astratti — attention, context window, parametri, Mixture of Experts — diventano improvvisamente oggetti fisici, con un peso e un posto dove stare.
Del progetto in sé qui non dirò molto: ci sto ancora litigando, e ne darò notizie quando ci sarà qualcosa da raccontare. Quello che segue è il passo precedente — le analogie che ho dovuto costruirmi per affrontarlo, utili per fissare concetti che già avevo in testa, smontarne di sbagliati che mi ero costruito, e riprendere in mano un ambito che dopo qualche esperimento fra il 2015 e il 2020 avevo abbastanza abbandonato.
Nessuna formula matematica (o quasi): partiamo da uno scriba, dei taccuini e una biblioteca.
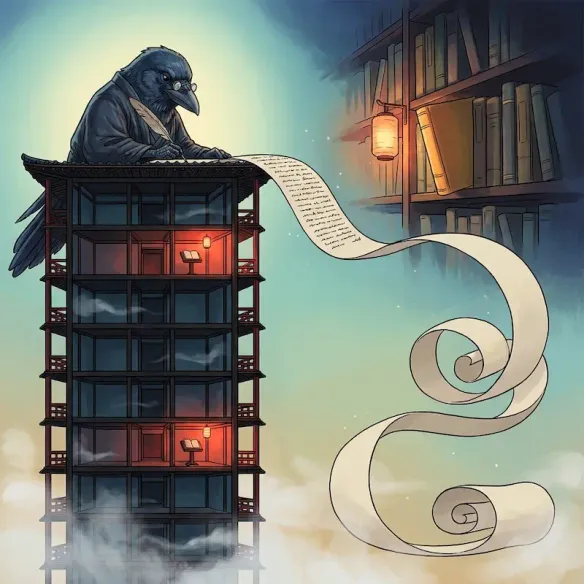
Il palazzo e lo scriba
Un modello linguistico che genera testo è uno scriba che scrive una parola alla volta: guarda tutto quello che è stato scritto finora e propone la parola successiva. Poi ricomincia.
È uno scriba al lavoro: le sue abilità sono già formate — le ha imparate a scuola, durante l'addestramento — e mentre scrive non impara più nulla. Tienilo presente, perché più avanti la distinzione conta.
Dentro, il modello (lo scriba) è fatto come un palazzo di piani (i layer): il testo entra dal piano terra e sale, e a ogni piano viene rielaborato un po'. Ogni piano deve fare la stessa cosa fondamentale: guardare le parole già scritte per capire il contesto. La differenza tra le architetture sta tutta in come ogni piano lo fa. I metodi principali sono due, e li vediamo uno per volta.
Il taccuino
Il primo metodo è l'attention, il meccanismo che ha reso famosi i Transformer. Nell'analogia: un taccuino.
Il piano prende appunti su ogni parola che passa e li conserva. Quando arriva una parola nuova, torna indietro e rilegge le pagine, decidendo quali contano di più in quel momento: "come si chiamava il robot? Ah sì, eccolo, tre pagine fa". È precisissimo nel richiamare dettagli, perché ogni parola ha la sua pagina di appunti, che non viene mai riscritta né compressa.
Ma ha un costo strutturale: più parole tieni, più pagine servono. Le pagine scritte, nel gergo tecnico, si chiamano KV cache — ed è la loro mole il vero prezzo dell'attention. Il taccuino cresce a ogni parola, per sempre.
Il riassunto mentale
Il secondo metodo è la ricorrenza: ascoltare tenendo a mente solo un riassunto, aggiornato di continuo. A ogni parola nuova, mescoli ciò che sapevi con ciò che è appena arrivato — un po' entra nel riassunto, un po' si sfuma — e vai avanti. Non ricordi ogni parola esatta: ricordi il senso accumulato.
Il pregio è enorme: il riassunto occupa sempre lo stesso spazio in testa, che il discorso duri un minuto o un'ora. Per un hardware con la memoria contata, è oro. Il difetto è speculare: sui dettagli precisi ("copia esattamente quel nome apparso ottanta parole fa") il riassunto è più sfocato di una pagina scritta.
C'è un'obiezione che a questo punto sorge spontanea a chi conosce la storia: il riassunto, visto così, è il vecchio meccanismo degli RNN — abbandonati anni fa proprio perché non si parallelizzano. Il difetto è nel meccanismo, non in una sua fase: ogni parola deve aspettare che la precedente abbia finito, quindi un testo qualunque è una fila indiana di passi, e le GPU — macchine fatte per fare mille cose insieme — restano ferme a guardare.
Il conto lo paghi due volte. Quando lo scriba deve digerire un testo che ha già davanti — la tua richiesta, un documento — mille parole sono mille passi, e aspetti. Ma il colpo mortale arriva a scuola, cioè in addestramento: i mesi in cui il modello impara leggendo montagne di testo prima di scrivere una sola parola per te. Lì di parole non sono mille: sono miliardi. In fila indiana non è lento — è impraticabile.
Il ritorno del riassunto lo rende possibile un dettaglio: chi regola il traffico all'ingresso. Immagina due vigili piazzati sulla porta del magazzino-riassunto. Il primo guarda la parola che arriva e decide quanto lasciarne entrare: "nome proprio, entri tutto"; "virgola, quasi niente". Il secondo, guardando la stessa parola, decide quanto sbiadire ciò che è già dentro. Non sono regole scritte a mano: i due vigili sono parametri, imparati a scuola come tutto il resto del cervello dello scriba, e da lì in poi congelati.
La differenza con l'RNN di una volta è tutta in dove sta il vigile. Prima stava dentro il magazzino: per decidere quanto lasciar entrare doveva prima guardare cosa c'era sugli scaffali. Un serbatoio la cui valvola è comandata dall'acqua che contiene — e allora la fila all'ingresso non può scorrere, si va per forza uno alla volta.
Ora i vigili stanno sulla porta e non guardano mai dentro. Guardano solo chi arriva. E allora, quando il testo ce l'hai già tutto davanti, puoi metterci sopra mille vigili in parallelo: ognuno legge la sua parola e ci annota due numeri, quanto entra e quanto sbiadisce. Nessuno aspetta nessuno.
Fatto questo, i riassunti non vanno più ripercorsi: si calcolano. Perché di riassunti non ce n'è uno solo — ce n'è uno per ogni punto del testo, visto che a ogni punto lo scriba deve poter proporre la parola dopo. E il contributo di una parola a un punto qualsiasi è semplicemente quanto era entrata, moltiplicato per tutti gli sbiadimenti che le sono passati sopra nel frattempo. Prodotti e somme, e i prodotti si possono raggruppare a piacere: fai metà testo e metà testo, poi combini; poi i quarti, poi gli ottavi. Mille riassunti si chiudono in una decina di passaggi ad albero invece che in mille in fila — con lo stesso identico risultato che avresti ottenuto andando in ordine.
Non fidarti: verifichiamolo coi numeri, in miniatura. Quattro parole; per ognuna i vigili hanno già annotato i due numeri — quanto entra (diciamo 6, 4, 2, 8) e quanto sbiadisce ciò che c'era prima (½ per tutte, per non complicarci la vita). In fila indiana: 6; poi 6·½ + 4 = 7; poi 7·½ + 2 = 5,5; poi 5,5·½ + 8 = 10,75. Tre passi, ognuno fermo ad aspettare il precedente.
Ad albero, invece: due squadre partono nello stesso istante. La prima lavora le parole 1–2 e consegna due numeri: «il mio pezzo vale 7, e qualunque cosa ci fosse prima di me la sbiadirei di ½·½ = ¼». La seconda, in parallelo, lavora le parole 3–4 come se il testo cominciasse lì, e consegna: «vale 2·½ + 8 = 9, sbiadimento ¼». Resta un solo passo di cucitura: 7·¼ + 9 = 10,75. Non simile: identico, al decimale — perché prodotti e somme danno lo stesso risultato comunque li raggruppi. Su quattro parole hai risparmiato un passo, gran cosa; ma su mille, la fila di mille passi si chiude in una decina di livelli.
E qui c'è la cosa che sorprende: non è una faccenda che riguarda solo la scuola. La divisione vera non è fra addestramento e uso, ma fra il testo che lo scriba ha già davanti e il testo che sta ancora producendo. Quando gli consegni la tua richiesta, quella è già tutta lì: entra nel magazzino in parallelo, in un lampo, mille vigili insieme. Poi lo scriba comincia a scrivere, e ogni parola che scrive rientra nel magazzino allo stesso identico modo — stessi due vigili, stesse regole — ma adesso una per volta, perché la parola dopo ancora non esiste.
Ecco perché un contesto lunghissimo viene digerito quasi subito mentre la risposta si fa aspettare: non sono due velocità, sono due regimi. E vale per il taccuino esattamente come per il riassunto: anche i Transformer digeriscono il testo che hanno davanti tutto in parallelo, e poi scrivono una parola alla volta. E il secondo regime, quello parola per parola, è precisamente quello che serve su un hardware piccolo: un aggiornamento alla volta, memoria sempre uguale.
Un'ultima cosa, che tornerà utile: ogni parola entra al suo peso pieno e da lì comincia a sbiadire. Il riassunto sa sempre benissimo cos'è successo poco fa, e sempre più vagamente cos'è successo all'inizio.
La ricetta dei piani
E allora perché scegliere fra Riassunti e Taccuini? La risposta che funziona è un mix, e si può scrivere come una ricetta: una lettera per piano. Per esempio, in un palazzo di otto piani:
R R A R R A R R
dove R è un piano a riassunto e A un piano a taccuino. Sei piani su otto lavorano a riassunto — quasi gratis per la memoria — e due tengono il taccuino, piazzati a distanza l'uno dall'altro, così quando serve ripescare un dettaglio preciso qualcuno ce l'ha scritto.
graph BT
  IN(["Testo in ingresso"]) --> P1["Piano 1 · R"]
  P1 --> P2["Piano 2 · R"]
  P2 --> P3["Piano 3 · A"]
  P3 --> P4["Piano 4 · R"]
  P4 --> P5["Piano 5 · R"]
  P5 --> P6["Piano 6 · A"]
  P6 --> P7["Piano 7 · R"]
  P7 --> P8["Piano 8 · R"]
  P8 --> OUT(["Parola successiva"])
  classDef acc fill:#ffe8cc,stroke:#e8892b,color:#111;
  classDef rec fill:#e7f0ff,stroke:#3b6fb0,color:#111;
  class P3,P6 acc
  class P1,P2,P4,P5,P7,P8 rec
Il testo entra dal piano terra e sale. In arancione i due piani a taccuino (A), in azzurro i sei a riassunto (R): è il pattern di Griffin — «due ricorrenti, uno di attention» — ripetuto.
Non è un'idea da hobbisti: DeepMind ha dimostrato con Griffin (e i modelli aperti RecurrentGemma) che questa alternanza, in proporzioni quasi identiche, regge il confronto con i Transformer puri usando meno memoria e generando più in fretta. La stessa leva funziona a miliardi di parametri su TPU e a milioni di parametri su un chip da pochi euro: cambia solo chi paga il conto della memoria.
Taccuini a dieta: meno pagine, un taccuino solo
Anche i due taccuini superstiti (se necessario) si possono mettere a dieta, con due trucchi.
La finestra scorrevole: il taccuino ha un numero fisso di pagine — diciamo 256. Scritta la 257ª, strappi la più vecchia. Non serve ricordare tutto il libro: per la sintassi e il filo del discorso basta il "recente".
Un taccuino solo per tutti i lettori (tecnicamente multi-query attention): finora ho descritto il taccuino di un piano come se lo tenesse una mano sola. In realtà su ogni piano ci sono più lettori — diciamo otto — e ognuno rilegge le stesse pagine con una domanda diversa in testa («chi è il soggetto?», «di che tempo parliamo?»). Di default ognuno tiene il suo taccuino: otto taccuini diversi, perché ognuno annota delle stesse parole solo ciò che serve alla sua domanda. Il trucco è banale e potentissimo — un taccuino solo, condiviso: tutti scrivono e rileggono le stesse pagine, ognuno con la propria domanda in testa. Si perde un po' di finezza — otto punti di vista costretti a spartirsi gli stessi appunti — ma in pratica è un prezzo che si paga volentieri. Il risparmio non viene dalla grafia più fitta, ma dal numero di taccuini: da otto a uno.
Ed è un asse, non un interruttore: a metà strada c'è chi tiene pochi taccuini condivisi da gruppi di lettori (la GQA), e chi invece comprime davvero le pagine in una forma sintetica (la MLA di DeepSeek). Ma quella è un'altra dieta.
Taccuino a pagine contate e uno solo per tutti i lettori: da voce di costo principale a spiccioli.
Il quaderno ad anelli
"Strappi la pagina più vecchia" è una buona immagine, ma prova a pensarci da bibliotecario: strappare la prima pagina e far scalare tutte le altre di un posto è un lavoraccio — e in un computer "far scalare" significa spostare fisicamente memoria a ogni parola. Uno spreco.
Il trucco con cui si implementa davvero si chiama buffer circolare, e nell'analogia è un quaderno rilegato ad anello: 256 pagine fisse e un segnalibro. Non si strappa mai niente. Quando il segnalibro arriva all'ultima pagina, torna alla prima e scrive sopra l'appunto più vecchio — che tanto era proprio quello da dimenticare. Le pagine non si muovono mai; si muove solo il segnalibro. La parola numero 300 finisce sempre sulla pagina 300 diviso 256, resto 44: un'operazione sola, sempre la stessa.
C'è un piccolo prezzo da pagare: le pagine non sono più in ordine di scrittura, quindi chi rilegge deve sapere che la più recente è quella col segnalibro e la più vecchia è quella subito dopo. In cambio, la memoria del taccuino è fissa per sempre: la si prepara una volta, all'accensione, e non cresce più di un byte — che è esattamente ciò che serve quando i byte si contano.
La context window è il tavolo dello scriba
Continuiamo a mettere pezzi nella nostra analogia: quando leggiamo "context window da un milione di token", stiamo parlando della dimensione del tavolo dello scriba — quanto testo il modello può tenere davanti e rileggere quando gli serve.
E capisci anche perché costa così tanto. Nei grandi Transformer il taccuino non è uno solo: ogni piano ha il suo, e nessuno strappa mai una pagina. Un milione di parole, per decine di piani, con appunti per ciascuna parola: centinaia di gigabyte di memoria solo di appunti, prima ancora di pensare. Ecco perché i contesti lunghi vivono nei data center: il problema non è solo ragionare, è tenere il taccuino aperto.
Il passaparola dei taccuini
Un'obiezione sensata: se ogni taccuino rilegge (nel nostro modello minimale) solo le ultime 256 parole, il modello è cieco oltre quella distanza? No, per due ragioni.
La prima: i piani a riassunto non hanno limiti — il riassunto si porta dietro tutto dall'inizio (semmai sbiadito), per costruzione.
La seconda è più sottile: i taccuini si passano il testimone. I piani sono impilati, quindi ogni piano non legge le parole originali ma il lavoro già elaborato dai piani sotto. Quando il taccuino del sesto piano rilegge una parola, quella parola contiene già ciò che il taccuino del terzo piano aveva ripescato per lei — che a sua volta guardava più indietro. Stesse posizioni sul tavolo, appunti sempre più raffinati man mano che si sale: messi in fila, i taccuini fanno viaggiare l'informazione ben oltre la singola finestra.
I parametri sono il cervello dello scriba
Fin qui abbiamo parlato solo di memoria di lavoro. Ma quando si dice che un modello "ha 70 miliardi di parametri", si parla di un'altra cosa: il cervello dello scriba.
I parametri sono i numeri che decidono come lo scriba fa ogni cosa: cosa merita di entrare nel riassunto e cosa dimenticare, quali pagine del taccuino rileggere, quale parola proporre dopo. Vengono appresi una volta, durante il training — la scuola dello scriba, milioni di storie e documenti letti — e poi congelati. Il taccuino e il riassunto cambiano a ogni testo e si buttano via alla fine; il cervello resta.
Tre memorie, da non confondere mai:
| Cosa | Nell'analogia | Quando cambia |
|---|---|---|
| Parametri | l'abilità dello scriba | mai, dopo la scuola |
| Stato e KV cache | riassunto + pagine del taccuino | a ogni parola |
| Contesto | il testo sul tavolo | cresce a ogni parola scritta |
"70 miliardi di parametri" e "1 milione di context window" sono assi ortogonali: quanto è colto lo scriba, e quanto è grande il suo tavolo. Puoi avere un mostro di cultura con un tavolino, o un tavolo da biliardo davanti a uno scriba poco colto.
Il gesto dello scriba: il matvec
Se i parametri sono il cervello dello scriba, il matvec è il gesto con cui li usa — l'unica mossa che ripete, migliaia di volte, per ogni singola parola.
Matvec sta per matrix times vector, matrice per vettore. In ogni istante, il pensiero corrente dello scriba è un vettore: qualche centinaio di numeri che rappresentano la parola in lavorazione, nel suo contesto. I parametri, invece, sono organizzati in matrici: griglie di numeri in cui ogni riga è una domanda imparata a scuola — "quanto c'è di nome proprio, qui? quanto va nel riassunto? quanto va dimenticato?". Il matvec pone tutte le domande al pensiero: prende una riga, la confronta numero per numero con il vettore, somma, e ottiene una risposta. Centinaia di righe, centinaia di risposte — che diventano il pensiero da passare al piano di sopra.
Tutto ciò che abbiamo incontrato finora — rileggere il taccuino, aggiornare il riassunto, scegliere il manuale, proporre la parola — sotto il cofano è questo gesto, ripetuto. Nei modelli linguistici, grandi o minuscoli, il lavoro è il matvec; il resto è contorno.
E c'è una sottigliezza che sul piccolo hardware diventa decisiva. Durante la scuola (il training) si elaborano migliaia di parole insieme: matrice per matrice, il regime che le GPU adorano, dove ogni peso caricato viene riusato mille volte. Ma lo scriba che genera lavora una parola alla volta: matrice per vettore. Ogni peso viene pescato dalla memoria, usato una volta sola, buttato. Il collo di bottiglia smette di essere "fare i conti" e diventa portare i pesi ai conti. Anche al microscopio, la domanda è sempre la stessa: quanto costa muovere i ricordi?
La biblioteca dei manuali
Ultimo pezzo: la Mixture of Experts (MoE), che nell'analogia diventa una biblioteca.
L'idea: non tutta la cultura dello scriba deve stare nella sua testa. Gran parte dei parametri può vivere in una biblioteca di manuali specialistici — gli esperti. A ogni parola, un bibliotecario velocissimo (il router) guarda il pensiero corrente — non la parola nuda, ma la parola già elaborata dai piani sotto — e decide: "questa sembra roba da manuale 17". Lo scriba consulta quel manuale, solo quello, e scrive. (Per la precisione, di biblioteche ce n'è una per piano, ognuna col suo bibliotecario e i suoi manuali; il principio è identico, quindi qui ne raccontiamo una sola.)
Il risultato è un trucco contabile potentissimo: il modello possiede tanti parametri, ma ne usa pochi per ogni singola parola. Cultura enorme, sforzo per parola piccolo.
Quanti manuali consulta lo scriba per ogni parola? Può essere uno solo — la scelta più aggressiva, quella dei modelli tipo Switch: massimo risparmio, ma il bibliotecario deve azzeccare al primo colpo. Oppure due o quattro, mescolati: più margine, più pagine da leggere. Uno è il minimo; il resto è un compromesso tra risparmio e sicurezza.
C'è però un guaio che salta fuori a scuola, ed è il vero problema della MoE: il bibliotecario pigro. Se nessuno lo obbliga, il router scopre presto che consigliare sempre il manuale 17 funziona benino un po' per tutto — e così quel manuale diventa dottissimo mentre gli altri restano vuoti, cultura pagata e mai usata. Si chiama collasso del router, e si cura aggiungendo alla scuola una regola in più: «distribuisci le domande», un premio a tenere i manuali bilanciati (il load balancing). Senza, hai comprato mille manuali per leggerne sempre uno.
I dadi truccati dello scriba
Lo so, avevamo detto che eravamo arrivati all'ultimo pezzo — ma al ritratto manca ancora qualcosa: come fa lo scriba, dallo stesso identico inizio, a scrivere ogni volta una storia leggermente diversa?
Il segreto è che lo scriba non propone mai una parola: propone una classifica di scommesse. A ogni passo, il suo lavoro produce una probabilità per ogni parola del dizionario: "drago 18%, principessa 12%, bosco 9%…" giù giù fino a parole assurde con probabilità microscopiche.
Se si prendesse sempre la prima classificata, lo stesso inizio darebbe sempre la stessa storia — e pure piatta e ripetitiva. Invece si estrae a sorte: una ruota della fortuna con gli spicchi proporzionali alle scommesse. "Drago" esce spesso, "bosco" ogni tanto, e ogni giro manda la storia su un binario un po' diverso — ma quasi sempre sensato, perché la ruota resta truccata a favore delle parole plausibili.
Due manopole governano la ruota. La prima (top-k) toglie dalla ruota tutti gli spicchi tranne i migliori — diciamo i primi 40 — così la coda lunga delle parole assurde non può uscire nemmeno per sfortuna. La seconda è la manopola dell'audacia (temperature): abbassata, esagera i divari e la favorita vince quasi sempre — storie prudenti e prevedibili; alzata, appiattisce gli spicchi — più sorpresa, più rischio di sbandare.
E un dettaglio da ingegneri: i dadi di un computer sono pseudo-casuali. Se fissi il "seme" della casualità, la sequenza di lanci si ripete identica — la stessa storia, riproducibile a comando. Utilissimo non per la poesia, ma per i test: puoi pretendere che due implementazioni diverse dello stesso scriba estraggano esattamente la stessa parola.
Il timbro FINE
Siamo alla fine ma, appunto, domanda: come fa lo scriba a fermarsi quando la storia è finita? Nessun timer, nessuna regola scritta a mano: l'ha imparato a scuola, come tutto il resto.
Il trucco sta nella preparazione dei testi di studio: ogni storia è stata chiusa con una parola speciale — un timbro FINE, una parola inventata che non esiste in nessun dizionario umano, aggiunta apposta al vocabolario. Dopo centinaia di migliaia di storie che finiscono con "…e vissero felici e contenti. ⟨FINE⟩", lo scriba ha interiorizzato la scommessa più naturale del mondo: dopo la chiusa di una favola, la parola più probabile è il timbro.
In generazione succede da sé: quando la ruota della fortuna estrae il timbro, lo scriba posa la penna, e il timbro viene tolto dal testo prima di consegnartelo. Nota la bellezza della cosa: la decisione di fermarsi è essa stessa una predizione, soggetta a dadi e manopola dell'audacia come ogni altra parola — per questo a volte la storia chiude in sessanta parole e a volte se la prende comoda.
E siccome gli scribi ogni tanto divagano, c'è la rete di sicurezza: un editore che, oltre un certo numero di parole, ritira la penna comunque — timbro o non timbro.
La scala della cartina
Il ritratto dello scriba è completo. Resta però ancora il problema dell'inizio: farlo stare in pochi megabyte. Perché il cervello appena uscito da scuola è pesante: ogni parametro è un numero con tanti decimali, e occupa quattro byte (due, nei modelli più recenti — comunque troppi). Milioni di parametri per un pugno di byte ciascuno: non ci stiamo.
La soluzione è la stessa delle cartine geografiche. Una cartina non scrive le distanze vere: le disegna in quadretti, e mette la conversione nella legenda a margine — "un quadretto = dieci chilometri". Con la quantizzazione si fa lo stesso ai parametri: si dividono in gruppetti (diciamo 64 alla volta), si annota a margine di ogni gruppetto la sua legenda — la scala, calibrata sul valore più grande del gruppo — e poi ogni numero si scrive come un conteggio di quadretti: un intero piccolo. Con un byte a numero hai una griglia fine (da −127 a +127); con mezzo byte una griglia grossa (da −7 a +7). (Simmetrica: si rinuncia a un valore per tenere lo zero esatto al centro — ecco perché −127 e non −128.) Per rileggere il valore vero: quadretti per legenda, fine.
La ripartizione segue il buonsenso: il cervello che sta sul tavolo, piccolo e sempre in uso, si tiene la griglia fine; la biblioteca — che è la mole vera — scende alla griglia grossa e si riduce di un fattore otto scarso rispetto all'originale a quattro byte — «scarso» perché anche le legende, con la loro scala, costano qualche bit. Il costo è una leggera sfocatura: come un MP3, che butta via precisione dove l'orecchio non sente. Ma "dove l'orecchio non sente" è una speranza, finché non la misuri.
La prova generale
E come lo misuri? Non puoi confrontare lo scriba compresso con quello originale a sensazione — "mah, le storie mi sembrano uguali" non è ingegneria. Serve una prova generale.
Si fa così: in laboratorio si costruisce il sosia dello scriba — il modello originale a cui si fanno indossare le stesse lenti arrotondate che avrà la copia da campo: ogni parametro viene compresso a quadretti e legende e subito riespanso, sfocatura inclusa. Poi si fanno leggere allo scriba originale e al sosia gli stessi identici testi d'esame, e si confrontano le loro classifiche di scommesse, parola per parola. Se le classifiche quasi coincidono, e la qualità misurata sui testi d'esame cala di un soffio — non "sembra uguale": cala di tanto così, misurato — la compressione è promossa.
E c'è un secondo dividendo, ancora più prezioso: da quel momento il sosia diventa il metro campione. La copia che andrà sul piccolo hardware, scritta da zero in un altro linguaggio, dovrà rispondere come lui — stesso testo, stesse classifiche, entro tolleranze dichiarate in anticipo. Ogni discrepanza oltre la tolleranza è un bug, e sai esattamente dove cercarlo. Lo scriba da campo non deve "andare bene": deve coincidere con il sosia, al decimale.
Quando la metafora diventa hardware
E qui si chiude il cerchio con l'idea testarda dell'inizio, perché su un hardware minuscolo questa metafora smette di essere una metafora.
Il chip con cui sto litigando ha due memorie: una piccola e veloce (la RAM) e una più grande ma lenta da leggere (la flash, quella delle chiavette USB). Ora che sappiamo come funzionano le cose, la disposizione si progetta da sola: il cervello dello scriba sta in RAM, sempre pronto; la biblioteca con i suoi manuali (MOE) sta su flash, e il manuale scelto dal bibliotecario viene letto solo nel momento in cui serve.
graph LR
  TOK["Ogni parola"] --> RT{"Bibliotecario (router)"}
  subgraph RAM["RAM · piccola e veloce"]
    B["Cervello — parametri sempre in uso"]
  end
  subgraph FLASH["Flash · grande e lenta"]
    L["Biblioteca di manuali — esperti (MoE)"]
  end
  RT -->|sceglie 1 manuale| L
  B --> CALC["Il calcolo della parola"]
  L -.->|solo quelle pagine, lette al volo| CALC
  CALC --> OUT["Parola scritta"]
Il cervello sta in RAM (sempre pronto); la biblioteca sta su flash e a ogni parola se ne «fotocopia» un solo manuale. La metrica che conta: quanti byte leggi dalla flash per token.
A quel punto la metrica di progetto più importante non è quanti parametri hai, ma quante pagine di manuale ti occorrono per ogni parola che scrivi — quanti byte devi leggere dalla flash per generare un token. Ed è una metrica che nessun data center ha mai avuto bisogno di inventare, perché nessun data center ha mai avuto pochi megabyte di RAM.
Il titolo di questo pezzo è una battuta, ma la storia è vera. Attention Is All You Need è il paper del 2017 che ha inventato i Transformer: tutti i piani a taccuino, nessun limite di pagine. Funziona meravigliosamente — finché non hai problemi di memoria.
I laboratori grandi rispondono ingrandendo il taccuino a forza di hardware; dal basso si fa l'inverso: taccuini minuscoli, quasi tutto a riassunto, la cultura in biblioteca. Due risposte alla stessa domanda: quanto costa ricordare?
(Nota a margine per chiudere un equivoco comune: "GPT" non è un sinonimo di "modello AI" — significa Generative Pre-trained Transformer. Il Transformer è l'architettura, il progetto del palazzo; GPT è una famiglia di modelli costruita su quel progetto, come "Golf" è una famiglia di automobili; ChatGPT è il prodotto che ci parla sopra.)
Riferimenti
Le immagini di questo pezzo sono generate da Claude su mio prompt, e le analogie sono nate in una lunga conversazione notturna con Claude Fable 5. Ma i concetti — e in qualche caso la metafora stessa, che il campo ha battezzato così fin dall'origine — vengono da qui:
- Vaswani et al., Attention Is All You Need (2017) — il paper dei Transformer: tutti i piani a taccuino.
- De et al., Griffin: Mixing Gated Linear Recurrences with Local Attention for Efficient Language Models (2024) — la validazione su larga scala del mix riassunti + taccuini locali.
- Botev et al., RecurrentGemma: Moving Past Transformers for Efficient Open Language Models (2024) — i modelli aperti costruiti su Griffin.
- Jacobs, Jordan, Nowlan, Hinton, Adaptive Mixtures of Local Experts (1991) — la biblioteca degli esperti ha più di trent'anni, e la metafora è nel titolo.
- Shazeer, Fast Transformer Decoding: One Write-Head Is All You Need (2019) — il taccuino condiviso (multi-query attention), da un altro titolo che gioca con lo stesso paper.
Glossarietto
| Analogia | Termine tecnico |
|---|---|
| Il palazzo, i piani | il modello, i layer |
| Lo scriba | il modello in inferenza |
| Il taccuino | attention |
| Le pagine del taccuino | KV cache |
| Pagine contate (strappa la più vecchia) | sliding window / attention locale |
| Il quaderno ad anelli col segnalibro | buffer circolare (KV cache a memoria fissa) |
| Un taccuino solo per più lettori | multi-query attention (MQA) |
| Il riassunto mentale | ricorrenza gated (stato a dimensione costante) |
La ricetta dei piani (R R A R R A R R) |
mixer pattern ibrido |
| Il tavolo | context window |
| Il cervello dello scriba | parametri (pesi) |
| Il pensiero corrente | vettore di attivazioni (hidden state) |
| Porre tutte le domande al pensiero | matvec (prodotto matrice-vettore) |
| La scuola | training |
| Quadretti e legenda a margine | quantizzazione groupwise (int4/int8 + scala) |
| La sfocatura | errore di quantizzazione |
| Il sosia con le lenti arrotondate | valutazione export-equivalent (quantizzazione simulata) |
| Coincidere col sosia, al decimale | golden vector e tolleranze |
| La biblioteca | Mixture of Experts |
| Il manuale specialistico | esperto |
| Il bibliotecario | router |
| Un solo manuale per parola | routing top-1 (Switch) |
| Il bibliotecario pigro (manuale 17) | collasso del router / load balancing |
| La classifica di scommesse | distribuzione di probabilità (logits) |
| La ruota della fortuna truccata | campionamento (sampling) |
| Gli spicchi migliori | top-k |
| La manopola dell'audacia | temperature |
| Il seme dei dadi | seed |
| Il timbro FINE | token di stop (end-of-text) |
| L'editore che ritira la penna | limite di token generati (max new tokens) |
| Pagine fotocopiate per parola | byte letti da flash per token |